On lit beaucoup d'affirmations assurées sur le comportement des crawlers IA face aux sites lents. La plupart ne sont pas sourcées, pour une raison simple : les sources n'existent quasiment pas. Comparés à Google, les éditeurs d'IA publient très peu de choses sur la mécanique de leurs crawlers.
Cet article s'en tient à ce que les éditeurs documentent réellement, et nomme explicitement les zones d'ombre. Quand une information n'est pas documentée, nous le disons plutôt que de la combler.
Les crawlers, et le rôle de chacun
Premier point à clarifier : « crawler IA » recouvre trois métiers différents, aux profils de latence très différents.
| User-agent | Éditeur | Rôle (tel que documenté) |
|---|---|---|
GPTBot |
OpenAI | Crawle du contenu pouvant servir à l'entraînement des modèles de fondation |
OAI-SearchBot |
OpenAI | Fait remonter des sites dans les résultats de recherche de ChatGPT |
ChatGPT-User |
OpenAI | Visite une page quand un utilisateur pose une question à ChatGPT ou à un GPT personnalisé |
ClaudeBot |
Anthropic | Collecte du contenu web pour l'entraînement et le développement des modèles |
Claude-SearchBot |
Anthropic | Indexe du contenu pour améliorer la qualité des résultats de recherche |
Claude-User |
Anthropic | Récupère des sites quand des utilisateurs posent une question à Claude |
PerplexityBot |
Perplexity | Fait remonter et lie des sites dans les résultats Perplexity |
Perplexity-User |
Perplexity | Récupère des pages quand la question d'un utilisateur l'exige |
Sources : documentation des bots OpenAI, article d'Anthropic sur son crawler, guide des bots Perplexity.
La distinction qui compte pour la performance oppose le crawl programmé (GPTBot, ClaudeBot, OAI-SearchBot, Claude-SearchBot, PerplexityBot) au fetch déclenché par l'utilisateur (ChatGPT-User, Claude-User, Perplexity-User). Nous y revenons plus bas : c'est là que le cache froid fait vraiment mal.
Ce que les éditeurs ne documentent pas
Deux choses sont absentes de la documentation des trois éditeurs, et ce sont précisément celles qu'on voudrait connaître :
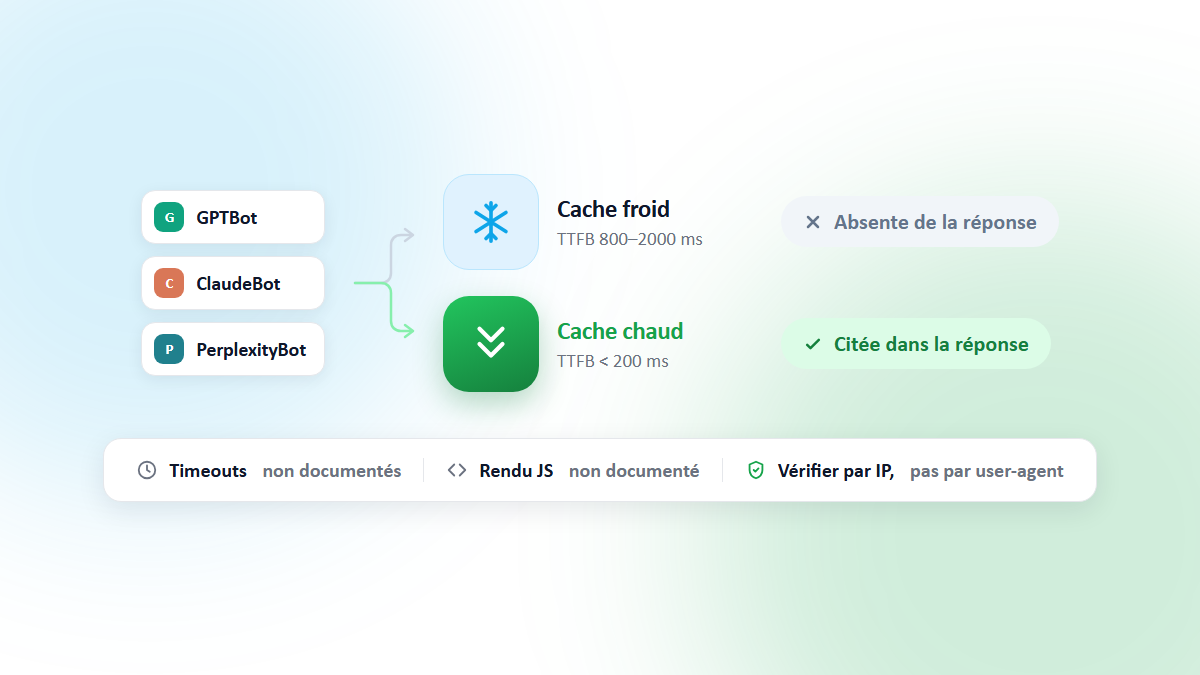
1. Les timeouts. Ni OpenAI, ni Anthropic, ni Perplexity ne publie de timeout de requête, de politique de retry, ni la moindre indication sur la lenteur qu'ils tolèrent avant d'abandonner. Si vous avez lu un chiffre précis quelque part, il ne vient pas de l'éditeur.
2. Le rendu JavaScript. Aucun des trois n'indique si ses crawlers exécutent JavaScript. C'est un vrai manque : Google, à l'inverse, précise explicitement qu'il sait traiter le contenu à l'intérieur de JavaScript tant qu'il n'est pas bloqué, et documente son pipeline de rendu depuis des années.
La conclusion honnête face à un comportement non documenté n'est pas « ils ne rendent pas le JS », mais n'en dépendez pas. Si votre contenu n'existe qu'après hydratation, vous pariez votre visibilité IA sur une capacité non documentée chez trois éditeurs différents, chacun libre de la changer sans préavis. Du HTML rendu côté serveur supprime purement et simplement le pari.
La même logique vaut pour la lenteur. Puisque aucun éditeur ne s'engage à patienter, l'hypothèse prudente est que la patience est courte et non annoncée. Une page qui répond en 150 ms ne pose aucun problème ; une page qui répond en 3 secondes parce que le cache vient d'être vidé est un pari contre une règle que personne n'a publiée.
Ce que les éditeurs ne disent pas, des tests indépendants permettent en partie de le combler. La section suivante détaille ce qu'un de ces tests a réellement mesuré.
Ce que les tests indépendants ont mesuré
Le silence des éditeurs ne rend pas le comportement inconnaissable : il oblige simplement à aller le mesurer. En janvier 2026, RESONEO a publié un test qui fait exactement cela : une page portant 15 méthodes d'injection de contenu différentes (HTML statique, <noscript>, JS inline, JS différé, fetch(), Shadow DOM, iframes, <template>), chacune contenant une chaîne sentinelle unique. Chaque assistant a ensuite été invité à consulter la page et à rapporter les sentinelles qu'il voyait, avec journalisation des en-têtes et des temps côté serveur.
Attention au périmètre : le test porte uniquement sur les fetchers déclenchés par l'utilisateur, et exclut explicitement les crawlers d'indexation (GPTBot, ClaudeBot). C'est précisément la distinction qui compte pour la latence.
| Assistant | User-agent observé | JavaScript | Attente du contenu |
|---|---|---|---|
| ChatGPT | ChatGPT-User |
Non | n/a |
| Claude | Claude-User |
Non | n/a |
| Gemini | Google |
Non | n/a |
| Perplexity | Perplexity-User |
Non (voir ci-dessous) | n/a |
| Grok | furtif, multi-IP | Oui, fetch() inclus |
~2 s |
| DeepSeek | furtif, Firefox | Oui, fetch() inclus |
~1 s |
| Bing Copilot | furtif, Chrome | Oui, Shadow DOM et iframes inclus | ~53 ms |
| Google AI Mode | aucun | Ne récupère aucune URL | n/a |
Quatre enseignements à exploiter :
- ChatGPT, Claude et Gemini ne lisent que le HTML statique. Ils captent le contenu de
<noscript>et de<template>, mais rien de ce que produit JavaScript. C'est une mesure et non un engagement d'éditeur, donc cela peut changer sans préavis, mais c'est la meilleure preuve disponible et elle va dans le même sens que l'hypothèse prudente. - Ceux qui exécutent le JS ont très peu de patience. Grok attend environ 2 s, DeepSeek environ 1 s, et Bing Copilot de l'ordre de 53 ms. Ce sont des attentes d'apparition du contenu, pas des timeouts HTTP, mais la direction est sans ambiguïté : une page encore en train de s'assembler après une seconde a déjà perdu.
Perplexity-Users'est présenté avec des en-têtes HTTP vides et n'a pas réussi à décoder la réponse compressée, ne voyant strictement rien. Si Perplexity compte pour vous, vérifiez comment votre origine et votre CDN traitent une requête avec unAccept-Encodingvide.- Google AI Mode ne va jamais chercher l'URL. Il répond depuis l'index de Search : le levier n'est donc pas la vitesse du fetch en direct mais l'indexation ordinaire et le budget de crawl, ce qui renvoie directement au rythme de crawl de Googlebot.
Les réserves, dites clairement : il s'agit d'une seule page de test, d'une seule agence, sans taille d'échantillon ni période de collecte publiées, et le comportement des crawlers change sans préavis. À traiter comme un signal fort plutôt que comme une spécification, à re-tester avant d'en dépendre, et dont la conclusion structurelle tient de toute façon : un contenu qui n'existe qu'après JavaScript est un contenu que la plupart des assistants IA ne voient pas.
Ce qui est documenté sur le rythme de crawl
Peu de choses, mais elles méritent d'être connues :
- Anthropic indique viser une « perturbation minimale en étant attentif à la vitesse à laquelle nous crawlons un même domaine », respecte
robots.txtet prend en charge la directive non standardCrawl-delay. - OpenAI et Perplexity documentent tous deux qu'une modification de
robots.txtmet jusqu'à 24 heures à prendre effet. - Perplexity précise que
Perplexity-Userignore généralementrobots.txt, au motif qu'un humain est à l'origine de la requête.
Aucun d'eux ne documente en revanche d'équivalent de la boucle de rétroaction de Google, où un serveur lent ou en erreur réduit mesurablement le volume crawlé. Avec Google, on peut raisonner sur le mécanisme. Avec les crawlers IA, non, ce qui est un argument de plus pour ne pas leur servir de pages lentes.
Où le cache froid coûte vraiment : le fetch en direct
Le crawl programmé est assez indulgent. Si GPTBot tombe aujourd'hui sur une page froide, il repassera probablement.
Les agents déclenchés par l'utilisateur, c'est une autre affaire. ChatGPT-User, Claude-User et Perplexity-User récupèrent votre page pendant que quelqu'un attend une réponse. Il n'y a ni file de retry ni second passage : la latence tombe au milieu d'une conversation en cours, et un fetch trop lent, c'est simplement une page qui n'entrera pas dans la réponse.
C'est la version GEO du problème du cache froid. Le raisonnement SEO traditionnel (page lente → signal affaibli → classement dégradé sur plusieurs semaines) est remplacé par quelque chose de bien plus immédiat : page lente → absente de cette réponse.
Et contrairement à un crawler, ces fetchs arrivent de façon imprévisible, au gré des questions posées. Impossible de les planifier. La seule défense est un cache déjà chaud au moment où ils se présentent.
Identifier le trafic des crawlers IA dans vos logs
Les chaînes de user-agent sont triviales à usurper : ce que vous devez en faire dépend donc de la question posée.
Pour mesurer des volumes et un taux de cache hit, classer sur le user-agent convient très bien. Personne n'a d'intérêt à falsifier un en-tête GPTBot pour fausser votre courbe de hit ratio : la mauvaise attribution est du bruit, pas un risque.
Pour tout ce qui relève de la confiance dans l'identité (autoriser, bloquer, limiter le débit, servir un contenu différent), vérifiez contre les plages que chaque éditeur publie en JSON :
- OpenAI :
openai.com/gptbot.json,openai.com/searchbot.json,openai.com/chatgpt-user.json - Anthropic :
claude.com/crawling/bots.json - Perplexity :
perplexity.com/perplexitybot.json,perplexity.com/perplexity-user.json
Une méthode de mesure concrète :
- Récupérez les logs ou les analytics de votre CDN, en conservant le statut de cache sur chaque ligne.
- Classez chaque requête dans un bucket de bot.
- Groupez par bot et par statut de cache (
HIT/MISS/EXPIRED) et calculez un taux de hit par bot. - Recoupez les lignes
MISSavec vos horaires de déploiement et de purge.
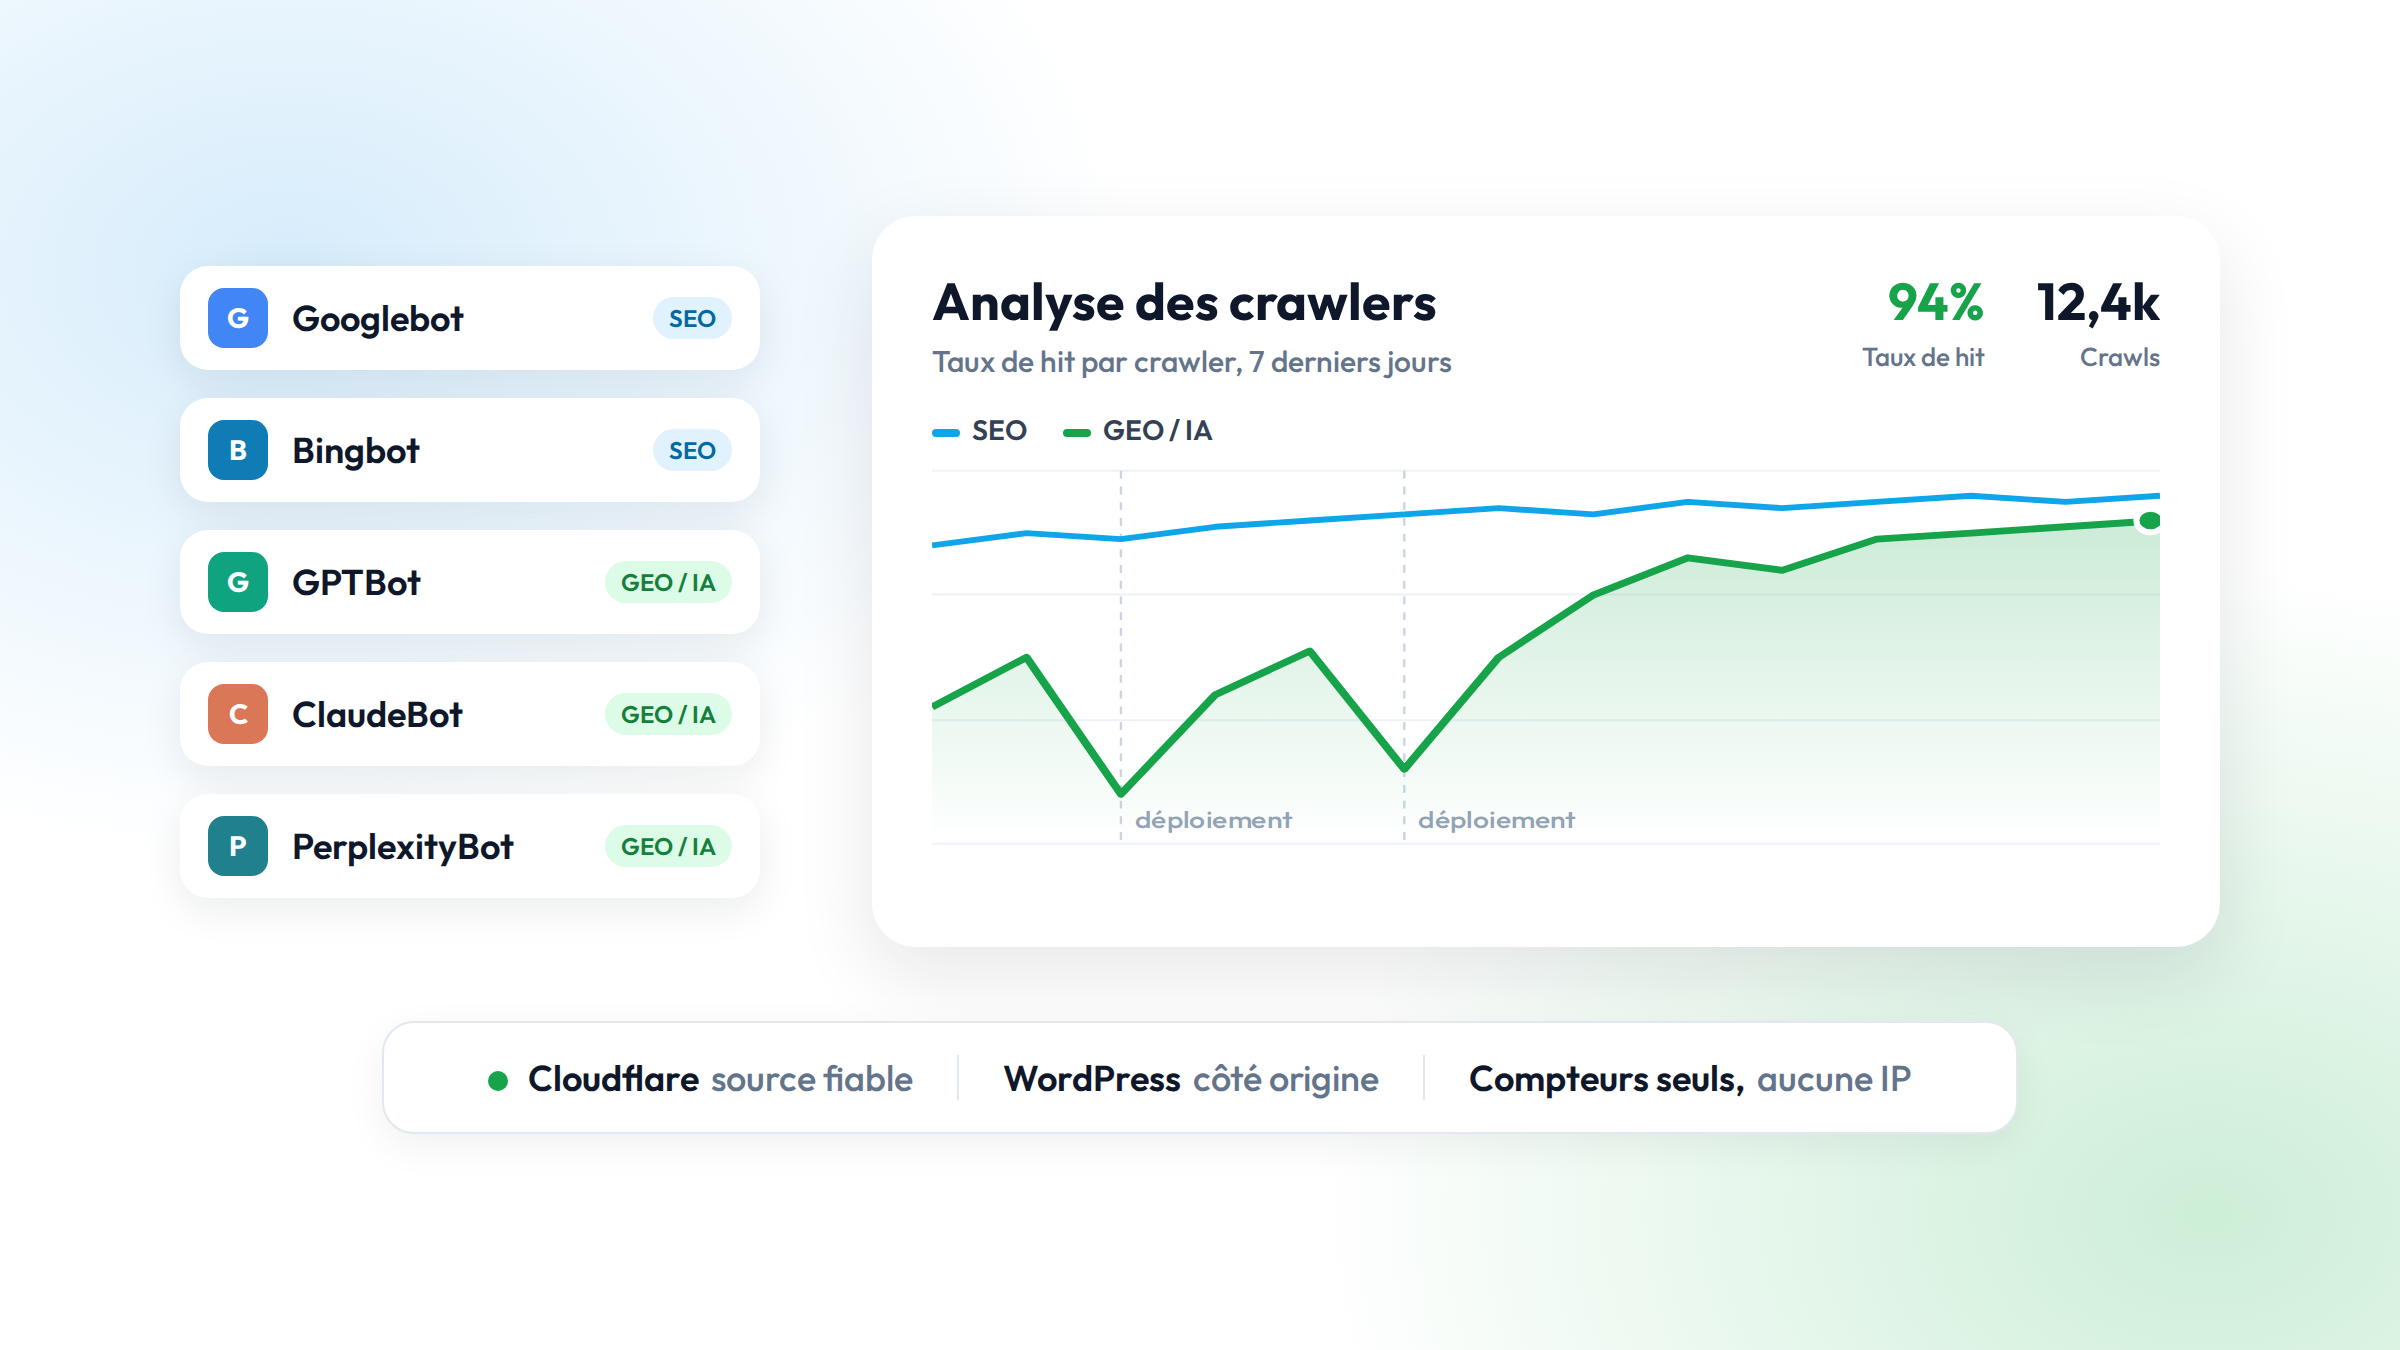
Si le taux de hit des crawlers IA est visiblement moins bon que votre taux global, la cause habituelle est un problème de timing : ces agents arrivent selon un calendrier que vous ne maîtrisez pas, et tombent donc de façon disproportionnée dans la fenêtre qui suit une purge, avant que le trafic organique n'ait reconstruit le cache. Le préchauffage referme cette fenêtre.
À noter qu'Anthropic avertit lui-même qu'un blocage par IP « peut ne pas fonctionner correctement » et recommande plutôt robots.txt. Cette réserve porte sur le blocage, pas sur l'observabilité.
Un mot sur votre WAF
Parce que les user-agents de bots sont si souvent usurpés, les solutions de bot management sont agressives envers les requêtes qui se réclament d'un crawler connu depuis une IP qui ne vérifie pas. C'est le comportement correct, et il a un effet de bord utile à connaître : si vous préchauffez votre cache avec un user-agent GPTBot ou ClaudeBot depuis votre propre infrastructure, votre WAF peut challenger ou rejeter ces requêtes, et le cache reste froid pendant que votre tableau de bord de préchauffage annonce un succès.
Whitelistez vos IP de préchauffage avant de préchauffer avec des user-agents de bots, et vérifiez d'abord si votre clé de cache varie seulement selon le user-agent : si ce n'est pas le cas, une seule variante les couvre tous.
Que faire, concrètement
- Servez le contenu dans le HTML. Aucun éditeur ne documente le rendu JavaScript, et les tests indépendants montrent que ChatGPT, Claude et Gemini ne l'exécutent pas. Ne pariez pas dessus.
- Gardez un TTFB bas en permanence, pas en moyenne. Les fetchs déclenchés par l'utilisateur arrivent au hasard, y compris juste après une purge.
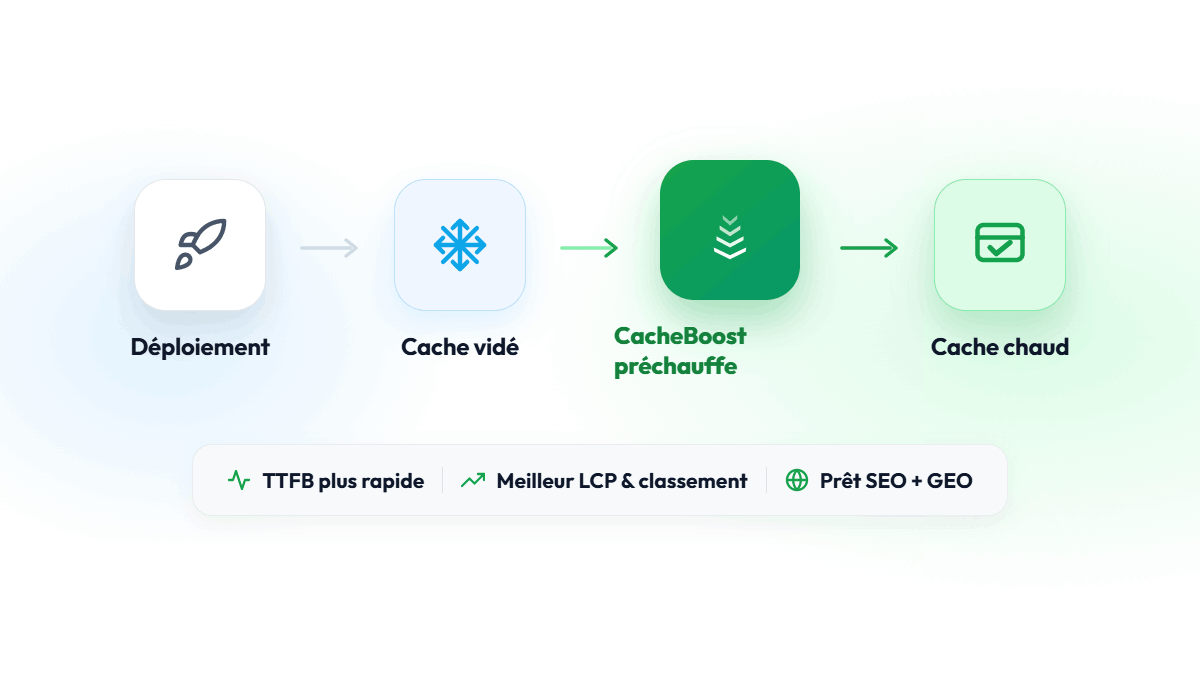
- Préchauffez après chaque vidage. C'est le seul moyen pour que la fenêtre post-purge cesse d'être un trou.
- Suivez le taux de cache hit par crawler. La dimension
cacheStatusde Cloudflare est la source autoritative du hit/miss ; groupée par bot, elle vous dit si les crawlers IA tombent systématiquement sur un MISS. L'analyse des crawlers de CacheBoost le fait pour vous dès que vous connectez un token API Cloudflare : elle interroge l'API GraphQL Analytics toutes les heures et sépare les crawlers SEO et GEO dans ses graphiques, ce qui vous donne le creux post-purge sans avoir à construire la chaîne vous-même.
À lire aussi : Pourquoi le préchauffage de cache est crucial pour le SEO et le GEO et Nouveau : suivez comment les crawlers SEO et IA touchent votre cache.